↑↓ / PgUp PgDn / колесо — навигация
Практический разбор · часть 2 · юбилейный выпуск

Как работает ИИ. Что у игрушек внутри

Первая часть была про молоток: модель предсказывает следующий токен, остальное - практика. За год вокруг молотка вырос ящик игрушек: картинки из текста, «убери очки», чтение зеркальных вывесок, расшифровка речи, голос по образцу, модель из фотографии. Эта часть про то, что у каждой внутри. Спойлер: внутри у всех тот же молоток, только токеном оказывается не слово, а кусочек шума, спектра или картинки.
Правила выпуска · почему юбилейный

Первое продолжение в коллекции, и одна нитка на все игрушки

Пять машин со снятыми крышками и один общий вал. Картинки в этом выпуске нарочно в другом стиле: гравюра в разрезе, потому что выпуск про «внутри».
  • Почему юбилейный. Тридцать с лишним лекций, и впервые не новая тема, а продолжение старой. Первая часть («Как работает ИИ: разбор для практиков») дала словарь: токен, веса, контекст, внимание, функция потерь. Здесь этот словарь не повторяется, а используется. Если его нет, часть 1 - двадцать минут.
  • Нитка. В каждой главе один и тот же вопрос в трёх шагах: во что игрушка превращает вход, что она предсказывает, и где она поэтому врёт. Ответы будут подозрительно одинаковые, и это главный результат выпуска.
  • Глубина. Без формул. Одна схема на механизм. Там, где по-настоящему не знают (почему именно эта сеть справляется с отражением), так и написано.
  • Два живых опыта. Оба поставлены при подготовке, результаты настоящие, включая ошибки: чтение зеркального текста и «убери очки» тремя разными кнопками. Там, где модель ошиблась, ошибка показана, потому что она объясняет механизм лучше, чем успех.
Маршрут

Семь игрушек, один приём

01 Диффузиякартинка из шума
→
02 Убери очкитри кнопки под одним словом
→
03 Зрениекак сеть видит
→
04 ЧтениеOCR и его смерть
05 Звук тудаWhisper: речь в текст
→
06 Звук обратноголос и музыка
→
07 Объём3D из картинки
→
Итогчто общее и где граница
Две первые главы про картинки, две про зрение, две про звук, одна про объём. Каждая кончается строкой в общей таблице: вход → во что превращён → что предсказывает → где врёт.
  • Что из части 1 понадобится. Токен как единица, которую модель предсказывает. Внимание как способ смотреть на весь контекст сразу. Функция потерь как число «насколько ошиблись», которое обучение гонит вниз. Этого хватит на все семь глав.
  • Чего не будет. Кнопок, цен и списков сервисов: это было бы «часть 1 снова». Здесь только механика. Если после выпуска кнопки стали понятнее, это побочный эффект, а не цель.
01 · Диффузия

Картинка из шума

Генератор картинок не рисует. Он учился на одном странном задании: ему показывали фотографию, испорченную шумом, и просили угадать, какой именно шум добавили. Миллиард раз. Потом ему дали чистый телевизионный снег и сказали: убери шум. Он убрал, и на месте снега оказалась картинка, которой никогда не было.

01 · Диффузия · обучение наоборот

Учим не рисовать, а угадывать, какой шум добавили

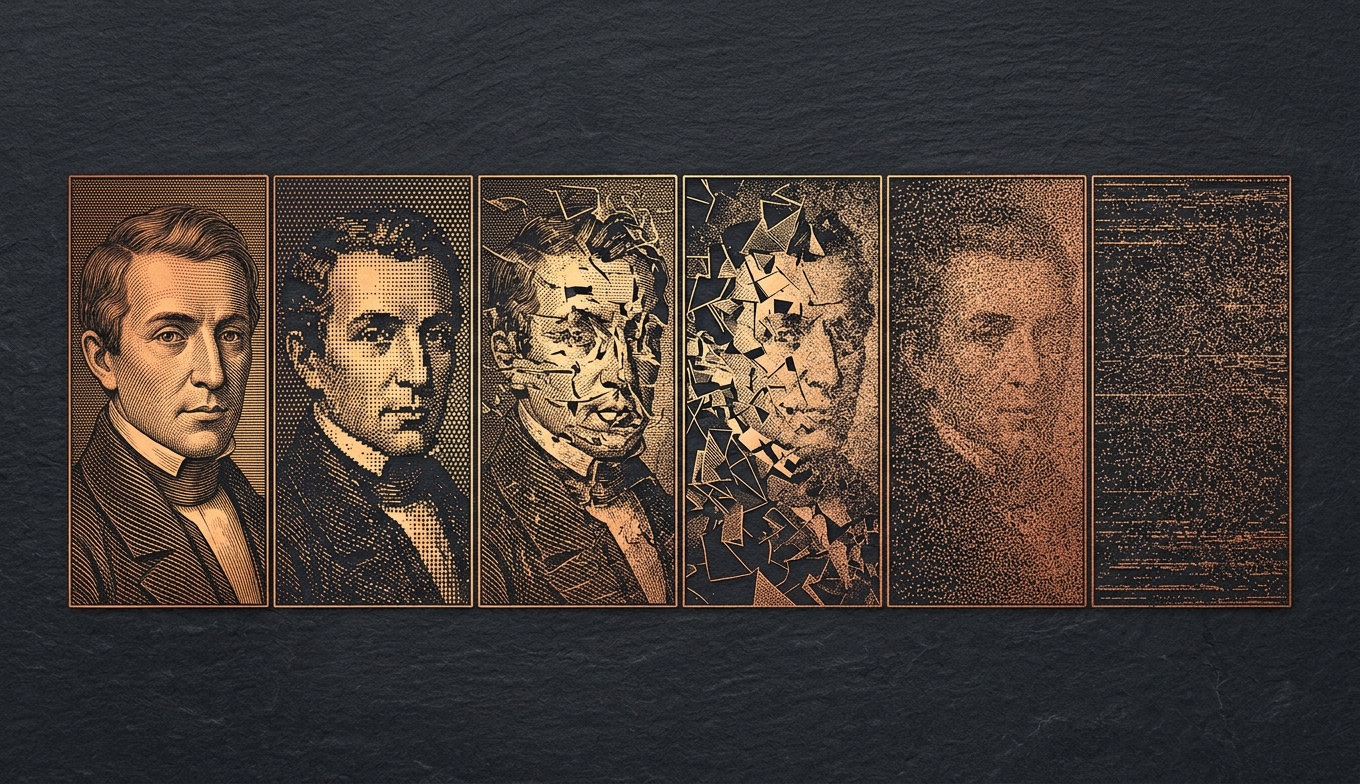
  • Прямой процесс. Берём фотографию. Добавляем немного случайного шума: каждому пикселю чуть-чуть случайной прибавки. Повторяем тысячу раз. К концу от фотографии ничего не остаётся, это чистый снег, и так с любой фотографией: все дороги ведут в один и тот же шум. Эта часть не обучается, это просто математика.
  • Задание сети. На каждом шаге показываем ей испорченную картинку и номер шага, и просим предсказать, какой шум был добавлен. Ответ известен (мы сами добавляли), значит, есть функция потерь: разница между угаданным шумом и настоящим. Обычное обучение, как в части 1, только предсказывается не токен, а шум.
  • Почему это работает. Чтобы угадать шум, надо понять, что под ним. На ранних шагах (шума мало) сеть учится мелочам: текстуре кожи, бликам. На поздних (шума много) - крупному: где голова, где фон. Одна сеть, тысяча уровней задачи. Так она выучивает, как устроены картинки вообще, не умея нарисовать ни одной.
Нитка: вход - картинка плюс шум, превращён в тензор чисел, предсказывается шум. Запомним: предсказывается не картинка.
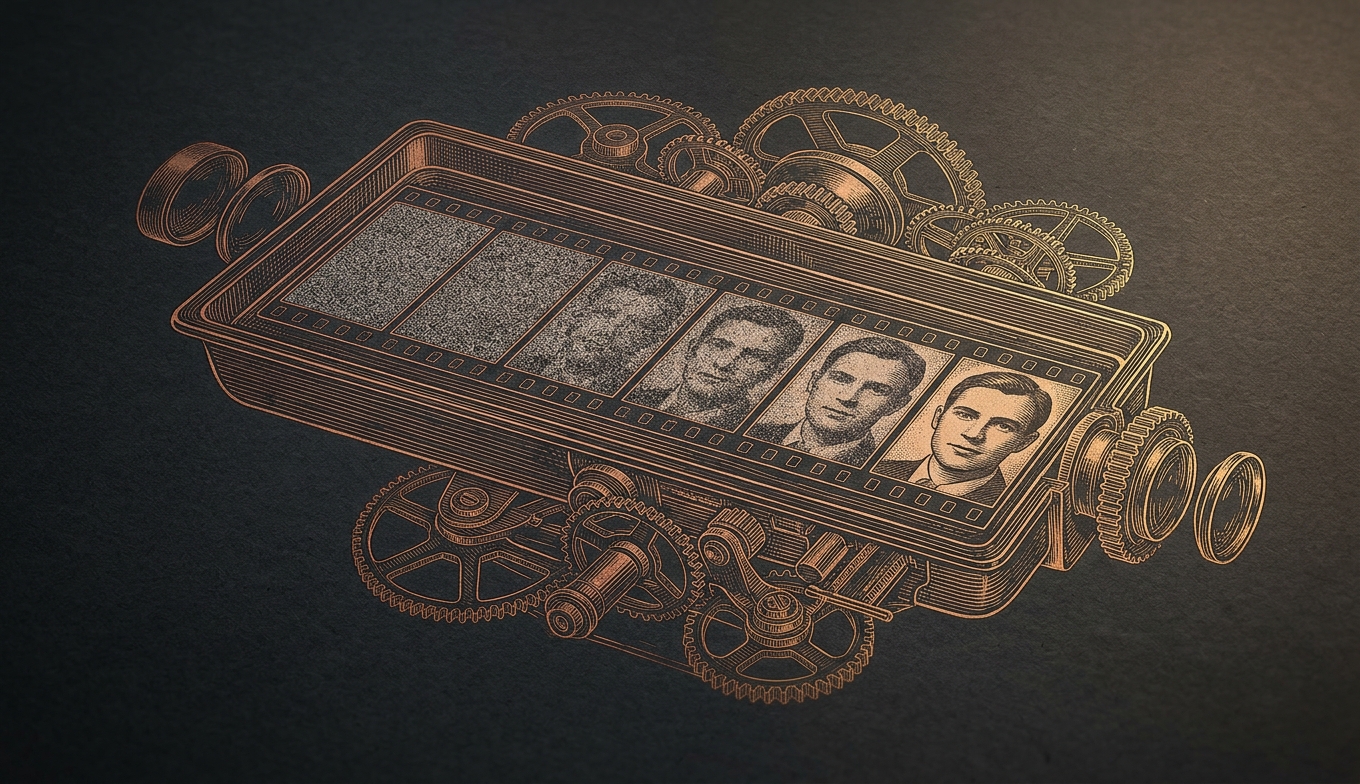
Прямой процесс: слева портрет, справа снег. Сеть учится ходить по этой полосе справа налево.
01 · Диффузия · генерация

Берём снег, тысячу раз вычитаем угаданный шум, и проявляется то, чего не было

обратный процесс
чистый снегслучайные числа
→
сеть: «вот шум»вычитаем часть
→
чуть меньше снегапроступают пятна
→
…ещё 20-50 раз
→
картинкакоторой не было
Каждый шаг - один прогон сети. Раньше тысяча, сейчас 20-50: придумали, как делать шаги крупнее (DDIM, DPM-Solver). Отсюда «steps» в настройках: меньше - быстрее и грубее.
  • Откуда разнообразие. Стартовый снег случайный. Другой снег - другая картинка по тому же промпту. Зафиксируй seed (число, из которого делают снег), получишь ту же. Seed - это не «стиль», это просто какой снег лежал в начале.
  • Проявление, а не рисование. Сеть ни на одном шаге не «решает нарисовать нос». Она на каждом шаге говорит «вот это похоже на шум, уберу», и нос остаётся, потому что он на шум не похож. Картинка - то, что не было признано шумом. Прунинг из «Мёртвых нейронов», только за секунды.

Почему пальцы

Генерация идёт не по пикселям, а по сжатой карте: картинка 1024×1024 сначала упаковывается кодировщиком в «латент» 128×128 с несколькими каналами, диффузия ходит там, потом декодер разворачивает обратно. Это в десятки раз быстрее, и это же причина мелких ошибок: пальцы, буквы, зубы - то, что в сжатой карте занимает пару клеток. Шесть пальцев - не «ошибка художника», а слишком мало клеток на руку.

Почему текст на картинках - каша

Та же причина плюс ещё одна: буква - объект, где важна точная форма, а диффузия учится на статистике «как обычно выглядит». «Как обычно выглядит текст» - это ровные строки чего-то буквоподобного. Новые модели (Banana Pro, Gemini Image) умеют текст потому, что их обучили на миллионах вывесок и дали внутрь языковую модель, которая знает, какие буквы должны стоять. Старые его не умеют по построению.

01 · Диффузия · откуда текст

Промпт не команда, а магнит: шум убирают «в сторону» вектора

  • CLIP. Отдельная сеть, обученная на 400 миллионах пар «картинка - подпись» так, чтобы вектор картинки и вектор её подписи оказывались рядом, а чужих - далеко. После обучения любой текст превращается в вектор, который «знает», как выглядит описанное. Это и есть мост между словами и пикселями.
  • Как он входит в диффузию. Сеть, угадывающая шум, на каждом шаге смотрит на вектор промпта через внимание, то же, что в части 1 между токенами. Теперь она угадывает не «какой шум», а «какой шум, если под ним должна быть кошка на окне». Вычитание шума сдвигается в сторону кошки. Промпт не рисует, он наклоняет.
  • Guidance (CFG). Сеть прогоняют дважды: с промптом и без, и разницу усиливают. Число 7 в настройках - во сколько раз. Мало - модель игнорирует текст, много - пережжённые цвета и уродства, потому что сдвиг стал больше, чем шум.

Почему «no text» в промпте не работает

Потому что магнит умеет только притягивать. Вектор «no text» - это вектор, в котором есть слово «text», и он тянет к тексту. Для отталкивания есть отдельный вход, negative prompt: второй вектор, от которого сдвиг направлен прочь. То, что мы пишем «no text» в основной промпт и это иногда помогает, объясняется только тем, что новые модели с языковой моделью внутри понимают отрицание как смысл, а не как магнит. Старые - нет.

Референс-картинка

Тот же механизм, что с текстом: картинку-референс превращают в вектор (CLIP умеет и это) и подмешивают во внимание. Модель тянется к «похожему на эту картинку» так же, как к «похожему на это описание». Поэтому референс задаёт настроение и композицию, а не копирует: это магнит, а не трафарет. Трафарет - следующая глава.

Строка в таблицу: вход - текст и снег; превращён в вектор и латент; предсказывает шум; врёт там, где мало клеток (пальцы, буквы) и где магнит тянет не туда (отрицания).
02 · Убери очки

Три разных механизма под одной кнопкой

Даёшь фото человека в очках и просишь «то же самое, но без очков». Что делает модель: рисует всё заново или трогает только кусок? Ответ: смотря какая кнопка. Их три, они устроены по-разному, и по результату можно определить, какая была нажата. Опыт в этой главе настоящий, одно лицо, три кнопки.

02 · Убери очки · три кнопки

Маска, частичный шум или картинка как токены

КнопкаЧто делает с оригиналомЧто перерисовываетЧто сохранится точноЧто может «поехать»
Inpaint (маска)снаружи маски пиксели оригинала замораживаются; внутри маски - чистый шумтолько дырку, на каждом шаге подглядывая в краявсё вне маски, до пикселяшов по краю маски; внутри может нарисовать не то (вторые очки, другие глаза)
Image-to-image (denoise)вся картинка зашумляется частично: denoise 0,3 - слегка, 0,8 - почти до снегавсю картинку целиком, стартуя не со снега, а с «подпорченного» оригиналакомпозиция и крупные формы (чем меньше denoise, тем больше)лицо, детали, фон: «тот же, но другой человек»
Инструктивная (Kontext, Banana Pro)картинка режется на токены и подаётся вместе с текстом «убери очки», как в чатевсё заново, но внимание держит каждый токен оригиналапочти всё, потому что модель «видит» оригинал на каждом шагемелочи, на которые не хватило внимания: родинка переехала, серьга пропала
  • Ответ на вопрос из заголовка. Inpaint - трогает только кусок, и это единственная кнопка, где слово «только» верно буквально. Две другие рисуют всё заново: img2img - стартуя с размытой копии, инструктивная - глядя на оригинал через внимание. Разница в том, что держит остальную картинку: заморозка пикселей, остаточный шум или внимание.
  • Как определить по результату. Увеличь фон. Пиксель в пиксель с оригиналом - inpaint. Тот же, но чуть иначе ложатся волосы и складки - img2img. Всё на месте, но одна мелочь исчезла или поменяла сторону - инструктивная. Следующий слайд - это проверка на живом примере.
02 · Убери очки · живой опыт

Одно лицо, одна просьба, четыре кнопки

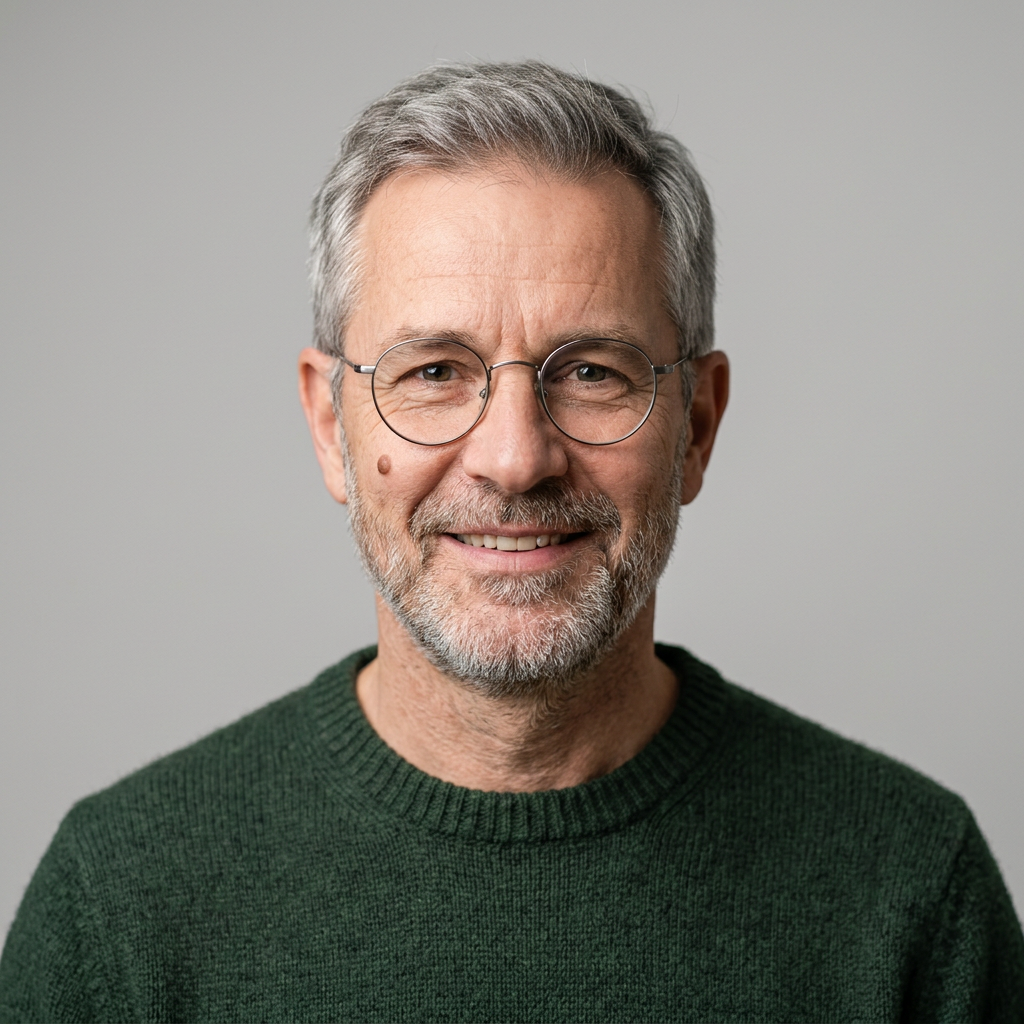
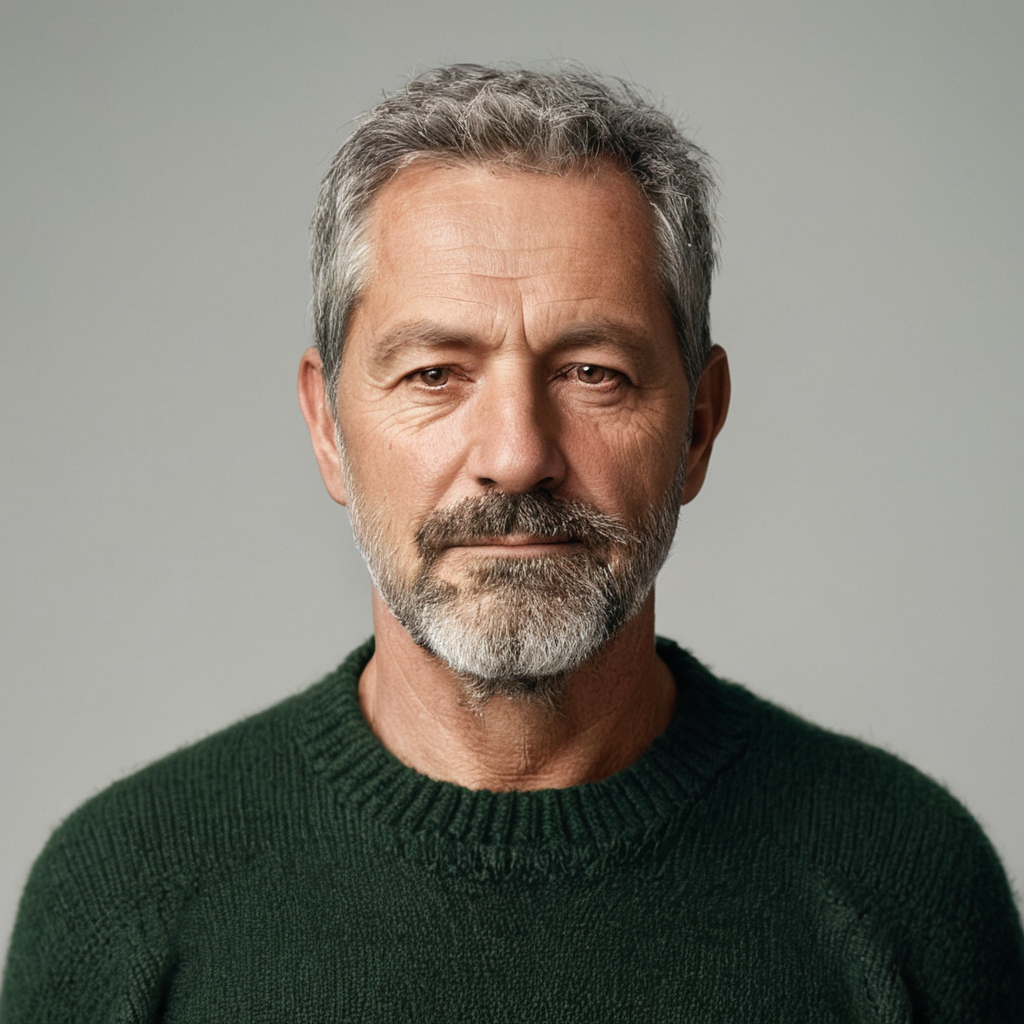
Оригинал

Сгенерирован для опыта. Следим за четырьмя приметами: очки, родинка на щеке, улыбка, борода.

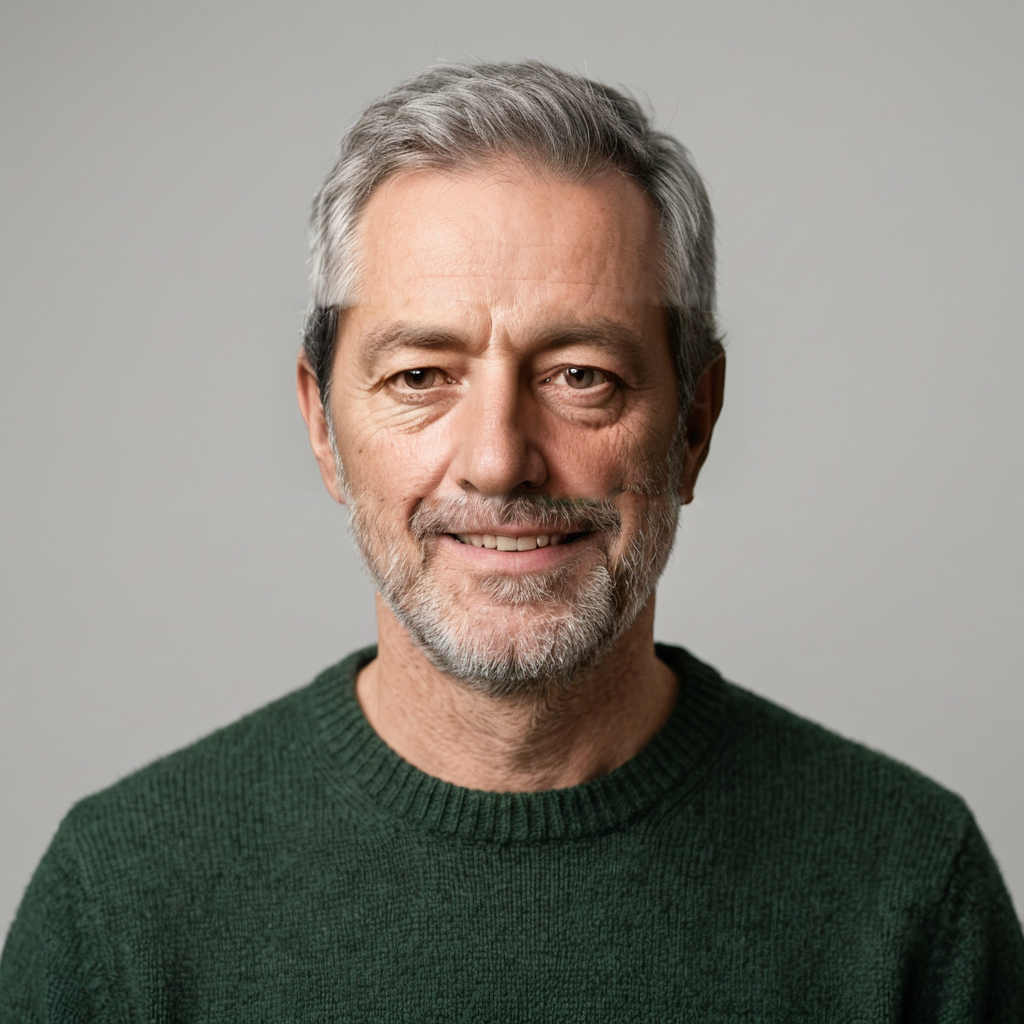
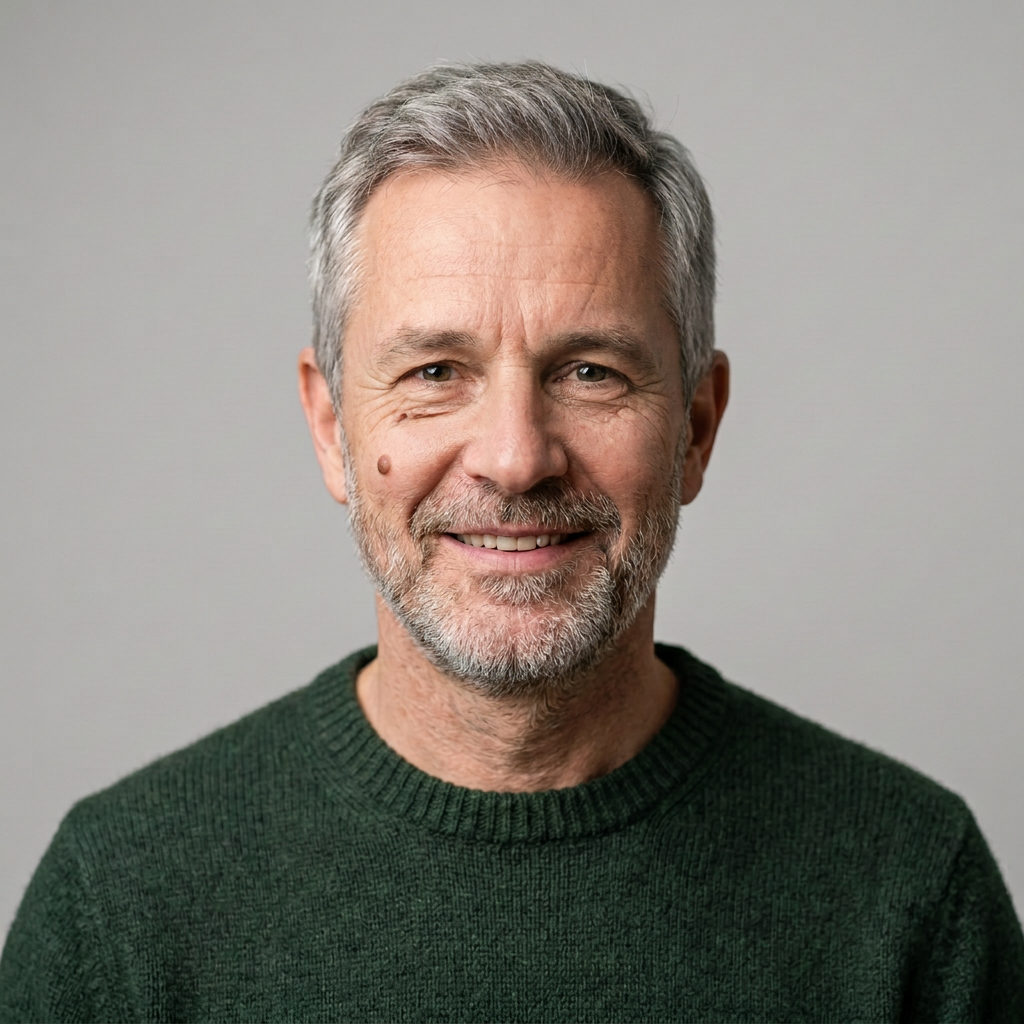
Inpaint, SDXL

Маска на зону глаз, снаружи заморожено. Очков нет, улыбка и борода пиксель в пиксель. Родинка попала в маску и исчезла: внутри маски рисуется всё заново, без оглядки на то, что там было.

Image-to-image, SDXL, denoise 0,55

Вся картинка зашумлена наполовину. Очков нет, свитер и фон те же, но человек другой: улыбка пропала, борода и кожа иные, родинки нет. «Тот же, но не тот».

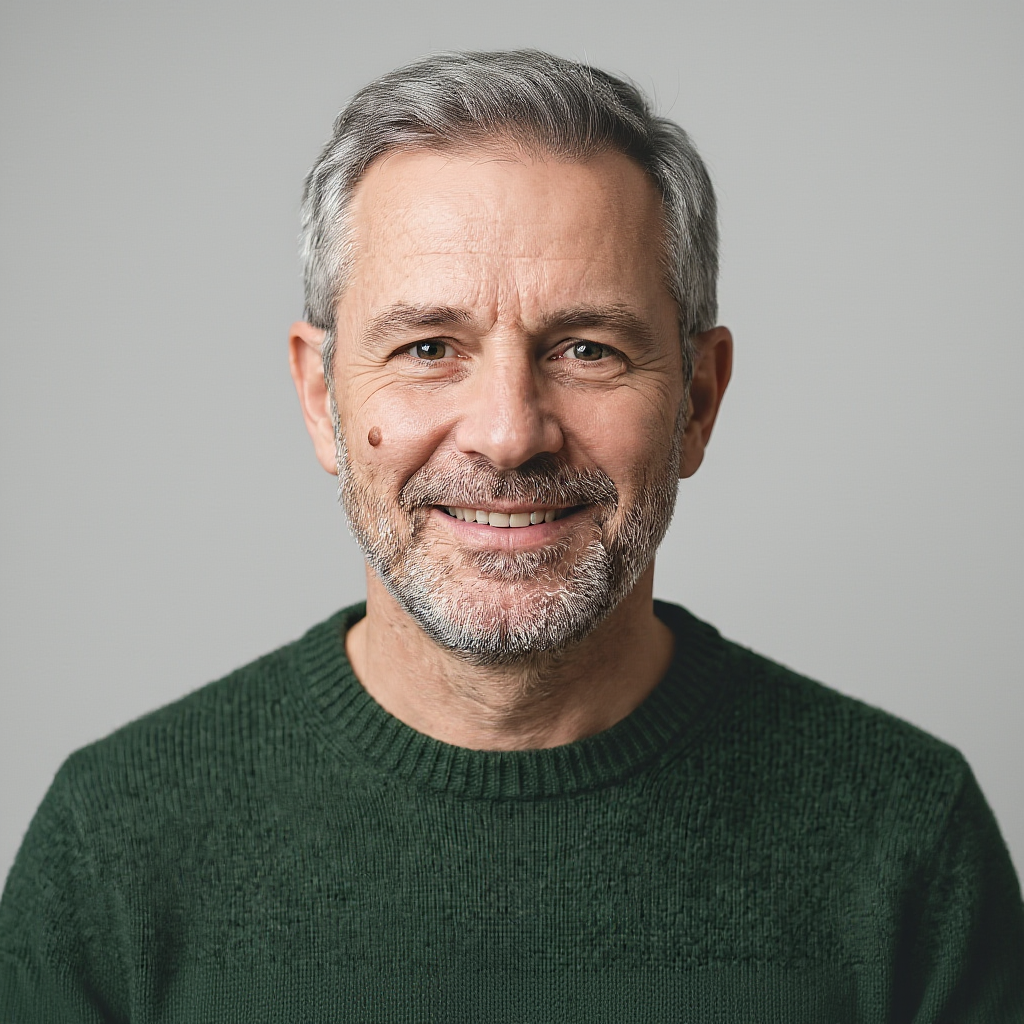
Инструктивная, Banana Pro

Картинка как токены плюс просьба. Очков нет, родинка на месте, улыбка на месте. Борода чуть короче, лицо чуть моложе: всё нарисовано заново, но под присмотром внимания.

Инструктивная, Flux Kontext

То же, локально, 115 секунд на домашней карте. Очков нет, родинка, улыбка и борода на месте, кожа чуть глаже. Из четырёх кнопок эта ближе всего к «только убери очки», и при этом перерисована каждая точка.

Что видно: единственная кнопка, которая буквально «трогает только кусок», inpaint, заодно стёрла родинку, потому что та попала в маску. Единственная, у которой человек остался тем же, инструктивная, нарисовала всё с нуля. «Только кусок» и «только то, что просили» - разные вещи, и держит их разное: заморозка пикселей или внимание. Условия: SDXL (Juggernaut XL) и Flux Kontext считались локально на домашней видеокарте, Banana Pro - в облаке; промпт везде один: «тот же человек без очков».
02 · Убери очки · фон долой

Удаление фона - не генерация, а раскраска: каждый пиксель «объект» или «фон»

  • Сегментация. Отдельная сеть, которая на вход берёт картинку, а на выход даёт такую же по размеру карту, где у каждого пикселя число от 0 до 1: насколько он «передний план». Училась на сотнях тысяч картинок с вырезанными вручную объектами. Никакой диффузии, никакого шума, никакого промпта: чистая классификация пикселей.
  • Почему она съедает тёмное на тёмном. Сеть выучила, что объект - это то, что отличается от окружения: по яркости, цвету, резкости края. Тёмная панель на тёмном фоне от фона почти не отличается, и для сети это фон. Кнопка, иконка, медальон на контрастном фоне - режутся идеально. Это не баг конкретного сервиса, это определение задачи.
  • SAM и «вырезать по клику». Segment Anything (Meta, 2023): та же идея, но с подсказкой: точка или рамка от пользователя, и сеть выделяет объект вокруг неё. Подсказка заменяет контраст: ты говоришь, где объект, и сети не нужно угадывать по яркости.
три операции, три разных сети
Диффузияпредсказывает шум, рисует
Сегментацияпредсказывает класс пикселя, режет
Апскейлпредсказывает недостающие пиксели между соседними
Под «редактором изображений» живут минимум три неродственные сети. Апскейл - ещё одна: ему показывают уменьшенную картинку и просят большую, и он тоже «не увеличивает», а дорисовывает детали, которых не было. Поэтому апскейл лица может слегка сменить человека.
Строка в таблицу: вход - картинка; превращена в карту признаков; предсказывает класс каждого пикселя; врёт там, где объект не отличается от фона.
03 · Зрение

Как сеть видит

Сеть не видит кошку. Она видит числа: яркость каждого пикселя. Чтобы из чисел получилась «кошка», нужно пройти десяток слоёв, и на каждом картинка становится чуть менее картинкой и чуть более смыслом. Эта глава про то, что происходит на каждом слое и почему кошке можно быть любого размера, повёрнутой и в зеркале.

03 · Зрение · свёртка

Маленькое окошко ищет один признак, слой за слоем: штрих, угол, глаз, лицо

Четыре слоя, четыре уровня: штрихи, углы, части, целое. Это не схема, так реально выглядят признаки, если их вытащить из обученной сети.
  • Свёртка. Берём окошко 3×3 пикселя с девятью весами. Прикладываем к каждому месту картинки, перемножаем, складываем, получаем одно число: насколько здесь есть «то, что ищет окошко». Одно окошко с весами «слева темно, справа светло» находит вертикальные края везде, где они есть. Сотня окошек - сотня признаков. Веса окошек не задаются, они обучаются, как всё остальное.
  • Иерархия. Выход первого слоя - сотня карт «где края». Второй слой смотрит окошком уже на них и находит сочетания краёв: углы, дуги. Третий - сочетания углов: глаз, колесо. Десятый - «морда кошки». Никто не говорил сети искать глаза; глаза оказались самой полезной комбинацией дуг для того, чтобы угадывать подпись.
  • Зайлер и Фергус, 2013. Вытащили, на что реагирует каждый слой настоящей сети. Первый - цветные штрихи и градиенты. Третий - текстуры и буквы. Пятый - лица собак, клавиатуры, глаза. Сеть сама придумала «части», потому что они экономят: один признак «глаз» полезнее тысячи признаков «пиксель».
Нитка: вход - пиксели, превращены в стопку карт признаков, предсказывается подпись (класс). Токена пока нет, но он появится через слайд.
03 · Зрение · инвариантность

Почему размер и поворот не мешают: сеть видела каждую кошку тысячей способов

  • Размер и сдвиг: встроено. Окошко одно и то же в любом месте картинки, значит, край найдётся, где бы ни был. Между слоями карту сжимают вдвое (пулинг: из четырёх соседних клеток оставляют максимум). После пяти сжатий «глаз» размером 30 пикселей и «глаз» размером 60 дают один и тот же отклик, потому что оба стали одной клеткой. Инвариантность к масштабу - побочный эффект сжатия.
  • Поворот и зеркало: выучено. В архитектуре этого нет, окошко «левый верхний угол» не найдёт правый нижний. Но при обучении каждую картинку показывают повёрнутой, отражённой, сжатой, в другом цвете (аугментация), и подпись та же. Сеть вынуждена найти признаки, которые от этого не зависят. Зеркальную «R» она читает не потому, что умеет отражать, а потому, что видела миллион отражённых букв с правильной подписью.
  • Проверка. Сеть, обученную без отражений, зеркальный текст ломает. С отражениями - нет. Это измеряется прямо: аугментация включена, точность на зеркале 90%, выключена - 30%. Способность не в сети, она в данных.
откуда берётся «всё равно какого размера»
сдвигодно окошко везде
масштабпулинг сжимает ×2 на слой
поворот, зеркалоне встроено: аугментации
освещение, цветне встроено: аугментации
Два свойства даны архитектурой, два куплены данными. Всё, что куплено данными, можно потерять, если данных такого типа не было.

Что сеть не видит: панда = гиббон

Гудфеллоу и соавторы, 2014: к фото панды добавили шум, невидимый глазу, подобранный так, чтобы сдвинуть признаки, и сеть с уверенностью 99% ответила «гиббон». Наклейка на дорожный знак «стоп» делает его для автопилота знаком «45». Сеть смотрит не на то, на что мы: она смотрит на статистику признаков, а статистику можно подделать, не трогая смысла. Это цена за то, что «кошка» для неё - вектор, а не кошка.

03 · Зрение · трансформер

Картинку порезали на квадратики и назвали их словами. Дальше часть 1

  • ViT, 2020. Досовицкий и соавторы (Google): режем картинку на квадраты 16×16 пикселей, каждый квадрат разворачиваем в вектор, это «токен». Картинка 224×224 - это 196 токенов, «предложение» из 196 слов. Дальше трансформер из части 1 без изменений: внимание, в котором каждый квадрат смотрит на все остальные.
  • Что это дало. Свёртка видит только соседей, и чтобы связать левый верхний угол с правым нижним, нужен десяток слоёв. Внимание связывает их на первом. Плюс одна архитектура на текст и картинки, и их можно подавать вперемешку: токены слов и токены квадратов в одной последовательности. Так появились модели, которые «читают» скриншот: для них это просто длинное предложение, часть которого из квадратов.
  • Цена. Трансформеру нужно больше данных, чем свёртке, потому что в нём нет встроенного «соседи важнее»: он это должен выучить. На малых данных свёртка лучше, на сотнях миллионов картинок трансформер уходит вперёд. Современные большие модели - трансформеры, иногда со свёрточным «предподготовителем» в начале.
одна последовательность
[квадрат]
[квадрат]
…196
«что»
«на»
«картинке»
Квадраты и слова в одном ряду. Внимание не знает, что одни из них - пиксели: для него всё токены. Отсюда «мультимодальность»: не два мозга, а один ряд.
Строка в таблицу: вход - картинка; превращена в 196 токенов-квадратов; предсказывается следующий токен (слово подписи или ответа); врёт там, где нужны пиксельные детали внутри одного квадрата и где признаки подделаны.
Следующая глава проверяет это на самом неудобном случае: чтение текста с картинки, зеркального и вверх ногами. Там впервые окажется, что читает не глаз.
04 · Чтение

OCR и его смерть

Тридцать лет чтение текста с картинок было отдельной наукой: найти строки, нарезать на буквы, сравнить с шаблонами. Потом нарезку убрали. Потом убрали и сам модуль: современная модель читает скриншот тем же вниманием, которым читает промпт. Поэтому она читает зеркальные вывески, и поэтому же врёт, когда не уверена: читает не глаз, а словарь.

04 · Чтение · три поколения

Шаблоны, потом полоса целиком, потом никакого OCR

ПоколениеКак находит текстКак читаетЧто ломает
Классический OCR, 1990-2010бинаризация (чёрное/белое), поиск строк по горизонтальным проекциямрежет строку на символы по пробелам между чёрными пятнами, каждый символ сравнивает с шаблонами шрифтовнаклон, слипшиеся буквы, рукопись, шум, любой нестандартный шрифт
Нейронный OCR, 2015-2022детектор, как для объектов: находит рамки текста любого размера и наклона (EAST, CRAFT)полосу читает целиком свёрточная сеть плюс рекуррентная, без нарезки на буквы; CTC: «выдавай букву, когда уверен, остальное пропускай»редкие языки, вертикальный текст, то, чего не было в обучении
Мультимодальная модель, 2023+не находит: вся картинка - токены, текст на ней такие же квадраты, как всё остальноевнимание между квадратами и словами; «чтение» - это предсказание следующего токена ответа при виде квадратовуверенные ошибки: читает то, что должно быть написано, а не что написано
  • CTC одной фразой. Сеть идёт вдоль полосы и на каждом шаге говорит либо букву, либо «ничего». «ПППРРРИИ_ВВЕЕТ» схлопывается в «ПРИВЕТ». Так сняли главную проблему старого OCR: не надо знать, где кончается одна буква и начинается другая.
  • Третье поколение. Модуля OCR больше нет. Это значит, что «распознавание» и «понимание» - одна операция, и их нельзя разделить: модель не может прочитать и не понять. Со всеми последствиями, см. следующие два слайда.
04 · Чтение · живой опыт

Зеркальный текст: читает не глаз, а словарь. Проверено на шести картинках

КартинкаБыло написаноМодель прочиталаИтог
обычный текстуснул окном окном сны часыуснул окном окном сны часыверно
зеркало, словакто стояли спал тёплой принёссырое чтение «стоили», словарь исправил на «стояли»верно, после поправки
зеркало, абракадабращдсгж аугмдум ббэддпвшдсгж вумдум ддеддпв3 слова из 3 с ошибками
вверх ногами, словатёплой мельник и до дотёплой мельник и до доверно
вверх ногами, цифры5 942 033 30 825 942 033 30 82верно
зеркало, цифры512 6961 670512 6961 670верно

Условия: фразы и абракадабра собраны генератором случайных слов, правильный ответ модели не показывали до чтения. Модель - та, что писала этот выпуск.

  • Что произошло на второй строке. Зрение выдало «стоили». Это ошибка: в зеркале «я» и «и» похожи. Но языковая модель внутри знала, что рядом с «кто» и «спал» вероятнее «стояли», и ответ ушёл правильный. Читал не глаз. Глаз ошибся, словарь поправил.
  • Что произошло на третьей. Абракадабре словарь помочь не может, и осталось чистое зрение. Оно спутало щ/ш, б/д, э/е, потеряло букву. Те же самые отражённые буквы, что строкой выше, но без подсказки они читаются втрое хуже. Способность читать зеркальный текст наполовину состоит из знания языка.
  • Почему цифры прошли. Алфавит из десяти знаков, и перевёрнутые цифры встречаются в данных часто (ценники, спидометры, отражения в витринах). У зрения хватает насмотренности на десять форм, но не на тридцать три в случайном порядке.
Строка в таблицу: вход - картинка с текстом; превращена в квадраты; предсказывается следующий токен ответа; врёт там, где словарь уверен, а глаз нет. Это не слабость, это та же сила: без словаря не было бы и второй строки.
04 · Чтение · раскладка

«djn cvjnhb»: модель не решает применить шифр. У неё нет шага «решить»

Случай

Собеседник пишет «djn cvjnhb? ns lf;t nfrjq ntrcn gjybvftim», модель отвечает по-русски на «вот смотри, ты даже такой текст понимаешь». Никакой картинки, чистый текст. Как она поняла, что надо переключить раскладку?

Никак. В русском интернете миллионы сообщений, набранных не в той раскладке, рядом с ответами и расшифровками. Для модели «djn cvjnhb» - не странные латинские буквы, а токены, которые в обучении встречались ровно в одном окружении: русский чат, не переключили. Соответствие клавиш выучено как обычная закономерность, как то, что после «привет» идёт «как дела».

Почему «решения» нет

Отдельного детектора «это тарабарщина, достать таблицу» внутри нет. Есть внимание и предсказание следующего токена. У строки «djn cvjnhb» в английском нет ни одного правдоподобного продолжения, в русском через раскладку есть, и представление токенов уже на первых слоях выглядит как «русские слова через клавиши». Контекст выбрал значение, как слово «лук» выбирается поваром из части 1. Ничего не применяется, оказывается единственным, при чём у фразы есть продолжение.

Проверка: та же строка внутри английского письма с заметной вероятностью прочитается как опечатка или пароль. Строка «gjhn» осмысленна в обеих раскладках («порт» и кусок английского), и выбор зависит только от языка разговора вокруг. Никакой таблицы, только вероятность продолжения.

Вывод главы: зеркальная вывеска, кривой скан, чужая раскладка - три разных входа, один механизм. ИИ не решает, что делать с входом. Он вычисляет, при каком прочтении у фразы есть продолжение. Это же объясняет, почему он иногда «понимает» не то: у того прочтения продолжение тоже было.
05 · Звук туда

Речь в текст: Whisper слушает глазами

Распознавание речи - это не про звук. Первым шагом звук превращают в картинку, спектрограмму, и дальше работает глава про зрение плюс часть 1: кодировщик смотрит на картинку, декодер пишет слова, предсказывая следующий токен. Отсюда всё хорошее и всё странное в Whisper: он знает языки, переводит и уверенно галлюцинирует в тишине.

05 · Звук туда · спектрограмма

Звук в картинку: время вправо, высота вверх, громкость яркостью

Спектрограмма: горизонталь - время, вертикаль - частота, яркость - сколько энергии. Гласные - полосы, согласные - шум, тишина - темнота.
  • Зачем. Волна звука - это 16 тысяч чисел в секунду, и в ней частота спрятана во взаимном расположении отсчётов. Преобразование Фурье по окошкам в 25 миллисекунд раскладывает каждый кусочек на частоты, и получается картинка 80 строк (частоты, по шкале слуха) на 3000 столбцов (30 секунд). Теперь это задача зрения.
  • Whisper, OpenAI 2022. Кодировщик - трансформер, который смотрит на спектрограмму как ViT на картинку. Декодер - языковая модель, которая пишет текст, на каждом шаге глядя через внимание на нужный кусок спектрограммы. Архитектура буквально «картинка в подпись», та же, что подписывает фото.
  • Обучение. 680 тысяч часов аудио с субтитрами из интернета, 97 языков. Без ручной разметки: субтитры и есть подпись. Треть задач в данных - перевод (английские субтитры к неанглийскому аудио), поэтому Whisper переводит, хотя его этому специально не учили. Он учил «что обычно пишут под этим звуком».
Нитка: вход - звук; превращён в картинку, а картинка в токены; предсказывается следующий токен текста. Это та же строка, что у чтения с картинок, и ошибки будут те же.
05 · Звук туда · где врёт

Тишина, повторы и «спасибо за просмотр»: декодер дописывает то, чего не слышал

  • Галлюцинации в тишине. Подаёшь 30 секунд шума вентилятора, получаешь «Субтитры сделал DimaTorzok» или «Спасибо за просмотр». Декодер - предсказатель следующего токена, в тишине он не получает подсказки от спектрограммы и пишет самое вероятное из обучения: то, что стояло под тихими концами роликов. Это не баг распознавания, это языковая модель без входа.
  • Зацикливание. Длинная запись, и с какого-то места текст повторяет одну фразу до конца. Декодер пишет по 30-секундным окнам, передавая предыдущий текст как контекст. Одна ошибка попадает в контекст, следующий кусок на неё опирается, и петля замыкается. Лечится тем, что предыдущий текст в контекст не передают, ценой качества на границах.
  • Имена и термины. «Гвендолин» превращается в «Гвендолен» или «квенделин», потому что в 680 тысячах часов этого слова не было, а похожих было. Словарь, который спасал зеркальный текст, здесь тянет к знакомому. Решение то же, что для людей: дать список имён заранее (промпт-подсказка в Whisper именно для этого).

Три проверки для расшифровки

  • Тихие места: если там связный текст - он выдуман.
  • Повторы одной фразы подряд: с этого места расшифровка мертва, перезапустить с другого окна.
  • Имена и цифры сверять по звуку: это ровно те места, где словарь сильнее слуха.

Почему это работает вообще

Потому что речь избыточна. Половину звуков в обычной фразе можно убрать, и человек поймёт по контексту. Whisper пользуется этим так же: слышит две трети, остальное дописывает языком. Пока дописывает правильно, это называется распознаванием. Когда входа нет совсем, та же операция называется галлюцинацией. Операция одна.

06 · Звук обратно

Голос по образцу и музыка из описания

Синтез речи - это распознавание, запущенное задом наперёд: текст в спектрограмму, спектрограмму в волну. Клонирование голоса - референс-картинка из первой главы, только референс звуковой. Музыка - диффузия из первой главы, только снег на спектрограмме целой песни. Новых механизмов в этой главе нет, и это её главный результат.

06 · Звук обратно · речь

Текст → фонемы → спектрограмма → волна, и вектор «кто говорит» между ними

синтез речи
текст«привет»
→
фонемып-р'-и-в'-э-т, ударение
→
спектрограмматрансформер рисует картинку звука
→
вокодеркартинка в волну
→
звук
вектор голосаиз 5-10 секунд референса: тембр, манера, акцент
↑ подмешивается в середину
Средний блок - обратный Whisper: не «картинка в текст», а «текст в картинку». Вокодер - отдельная сеть (HiFi-GAN и наследники), которая умеет из спектрограммы восстановить волну с фазой, которой на картинке нет.
  • Клонирование. Отдельный кодировщик превращает несколько секунд чужой речи в вектор: это тот же приём, что референс-картинка в диффузии и вектор промпта в CLIP. Трансформер рисует спектрограмму «в сторону» этого вектора. Поэтому клон держит тембр и акцент, но не держит то, чего в пяти секундах не было: смех, крик, другой язык, и дорисовывает их «как обычно».

Почему современные голоса не звучат как робот

Старый синтез склеивал записанные куски, и швы было слышно. Нейронный рисует спектрограмму целиком, с интонацией, которая выучена из тысяч часов живой речи: где поднять, где пауза, где придыхание. Это та же «статистика как обычно» из диффузии: голос звучит естественно, потому что он среднее по всем, кто так говорил. И по той же причине на незнакомом слове он споткнётся: имени «Гвендолин» в статистике нет, ударение будет угадано.

Строка в таблицу: вход - текст и образец голоса; превращены в фонемы и вектор; предсказывается спектрограмма (кадр за кадром, как токены); врёт на редких словах и эмоциях, которых не было в образце.
06 · Звук обратно · музыка

Песня из описания: диффузия по спектрограмме, и вокал - самое узкое место

  • Механизм. Берём спектрограмму целой песни (три минуты - картинка 80 на 18 тысяч), зашумляем, учим угадывать шум по описанию «грустный вальс, женский вокал, виолончель». Генерация - из снега, как в главе 1. Либо второй вариант: звук режут на токены кодеком (как слова), и дальше языковая модель предсказывает следующий звуковой токен. Suno и Udio не раскрывают, что именно внутри, но оба механизма - из этого выпуска.
  • Почему слова в песне - каша. Текст и музыка рисуются одновременно, одной сетью, в одной картинке. Вокал занимает узкую полосу спектра, и слово «любовь» в нём - несколько клеток, как палец в латенте. Плюс та же проблема, что с буквами на картинках: слово требует точной формы, а диффузия знает «как обычно звучит пение». Получается «как обычно»: похожее на слова пение.
  • Почему при этом гармония в порядке. Аккорды и ритм - крупные, повторяющиеся структуры, их в данных миллионы, и они занимают большие области спектрограммы. Крупное диффузия делает хорошо, мелкое плохо, и в музыке мелкое - это именно слова. Та же асимметрия, что лицо против пальцев.

Нитка затянута

Шесть глав, три с половиной механизма: диффузия (угадай шум), трансформер (угадай следующий токен), свёртка (найди признак окошком) и половинка - вектор-магнит (CLIP, референс, вектор голоса), который все три связывает с текстом. Картинки, редактирование, зрение, чтение, речь в обе стороны, музыка - всё собрано из этих деталей в разном порядке. Ни одной новой детали после первой главы не понадобилось.

Строка в таблицу: вход - описание; превращено в вектор; предсказывается шум на спектрограмме или следующий звуковой токен; врёт в мелком (слова), держит крупное (гармония).
07 · Объём

Модель из картинки

Последняя игрушка и единственная, где данных по-настоящему мало: фотографий в интернете миллиарды, трёхмерных моделей - миллионы, и то в основном кресла. Поэтому 3D-генерация делает крюк через картинки: сначала диффузия рисует объект с нескольких сторон, потом другая сеть сшивает виды в объём. И поэтому снаряды выходят, а лица нет.

07 · Объём · как и почему так

Нарисовать с шести сторон, потом сшить: крюк через картинки из-за нехватки данных

текст или фото → модель
входописание или одно фото
→
мультивиддиффузия, обученная рисовать один объект с 4-6 ракурсов согласованно
→
объёмсеть превращает виды в поле «внутри/снаружи» или облако точек
→
сеткаиз поля вырезают треугольники, UV, текстура с тех же видов
Два звена из трёх - уже знакомые: диффузия и сеть, предсказывающая число для каждой точки (как сегментация, только в 3D: «эта точка внутри объекта или снаружи»).
  • Второй путь. Диффузия сразу в трёхмерном представлении: шум не на картинке, а на сетке вокселей или на облаке точек. Честнее, но данных для обучения в тысячу раз меньше, чем картинок, и качество соответствующее. Поэтому коммерческие сервисы (Meshy и родня) делают крюк через виды: там можно опереться на всё, что модель знает о картинках.
  • Авториг. Скелет по форме предсказывает сеть ключевых точек, та же, что ставит точки на суставах человека на фото, только в 3D. Работает на том, что похоже на гуманоида, и промахивается на всём, где суставов «не положено».

Почему лица не выходят, а снаряды выходят

Три причины сразу. Данных: кресел, оружия и ваз в 3D-коллекциях много, человеческих лиц с хорошей топологией мало. Согласованности: мультивид рисует шесть картинок, и на лице любое расхождение между видами (глаз чуть выше слева) превращается при сшивке в уродство, на снаряде расхождение в миллиметр никому не видно. Зрителя: лицо мы читаем специальной зоной мозга и замечаем ошибку в полпроцента, на мече не замечаем и в десять.

Строка в таблицу: вход - текст или фото; превращено в несколько видов; предсказывается шум на видах, потом «внутри/снаружи» для точек; врёт там, где виды не сошлись, и там, где данных не было: лица, руки, тонкие детали.
Итог

Что общее и где граница

Семь игрушек разобраны до вала. Осталось положить детали в один ряд и посмотреть, сколько их на самом деле. Меньше, чем кажется: три механизма и один магнит. И одна общая слабость, которая на каждом этаже называлась по-своему, а оказалась одним и тем же.

Итоги · карта

Вся лекция одной таблицей: вход, во что превращён, что предсказывает, где врёт

ИгрушкаВходВо что превращёнЧто предсказываетГде врёт
Диффузиятекст + снегвектор CLIP + латент 128×128шум на каждом шагемелкое: пальцы, буквы; отрицания
Убери очкикартинка + просьбазаморозка / остаточный шум / токенышум, с оглядкой на оригиналшов маски / «другой человек» / потерянная мелочь
Фон долойкартинкакарта признаковкласс каждого пикселяобъект не отличим от фона
Зрениекартинка196 квадратов-токеновследующий токен подписидетали внутри квадрата; подделанные признаки
Чтениекартинка с текстомте же квадратыследующий токен ответасловарь уверен, глаз нет: абракадабра
Речь в текстзвукспектрограмма → токеныследующий токен текстатишина, повторы, имена
Текст в речьтекст + образецфонемы + вектор голосаспектрограмма кадр за кадромредкие слова, эмоции не из образца
Музыкаописаниевекторшум на спектрограмме / звуковой токенслова; держит гармонию
3Dтекст или фотонесколько видовшум на видах, внутри/снаружилица, руки, несогласованные виды
Четвёртый столбец. Девять игрушек, и в нём всего три разных слова: шум, следующий токен, класс точки. Пятый столбец ещё короче: везде врёт там, где мало клеток на деталь, и там, где словарь (статистика «как обычно») сильнее входа. Это не девять технологий. Это одна операция, предсказание по статистике, девять раз поставленная на разный вход.
Заключение · вопрос и мораль

Если внутри везде одно и то же, что тогда «понимает» модель

Вопрос на подумать

Выпуск показал, что чтение зеркальной вывески - это наполовину словарь, распознавание речи - наполовину дописывание, картинка - то, что не признали шумом. Нигде нет шага «понять». Есть «предсказать по статистике при таком входе». И при этом результат неотличим от понимания, пока вход достаточен, и становится галлюцинацией, когда входа нет, той же операцией.

Тогда вопрос: отличается ли это от того, что делаем мы, когда читаем «по дорвое шёл чеолвек», не замечая перестановок? Выпуск на него не отвечает. Он только замечает, что граница между «понял» и «дописал» проходит не внутри модели, а в том, достаточно ли было входа. И это проверяемо: дай меньше входа, и увидишь, где кончается чтение.

Мораль

Ex umbra in solem.

«Из тени на свет». Девиз, который ставили на солнечных часах: без тени нет времени, но читать время можно только там, где свет. Диффузия делает это буквально: из снега, в котором нет ничего, за пятьдесят шагов проявляет картинку, и на каждом шаге решает только одно: что здесь тень, а что нет.

Первая часть кончалась «Fabricando fit faber»: мастером становятся, делая. Вторая добавляет, что именно делает мастер: убирает тень. Не добавляет знание, а вычитает шум, пока не останется то, что на шум не похоже. Модель так рисует, так читает и так слушает. Мы так, кажется, понимаем.

Подвох: на солнечных часах, чтобы прочитать время, нужна тень. Убери её совсем, и часы покажут полдень вечно. Модель без шума на входе - это Whisper в тишине: уверенный текст ни о чём.

Итог · Ex umbra in solem

Внутри у всех игрушек один молоток. Он просто бьёт по разному шуму

Снег, в котором проявляется картинка. Маска, остаточный шум или внимание, которые держат остальное. Окошко, ищущее штрих, и квадраты, ставшие словами. Словарь, который читает зеркало за глаз. Спектрограмма, которую слушают глазами. Голос как вектор. Шесть видов, сшитых в объём. Вопросы → давайте обсудим.